TurboQuant KV 캐시 압축
TurboQuant는 긴 컨텍스트 추론을 위한 KV 캐시 압축 모드입니다. mlxcel은 attention 캐시의 일부를 더 작은 양자화 형식으로 저장하여 메모리 사용량을 줄입니다. 모델 가중치나 프롬프트는 바꾸지 않습니다.
실제로는 모델 자체는 메모리에 올라가지만 긴 대화나 여러 동시 요청을 기억하기 위한 메모리가 부족할 때 쓰는 기능이라고 보면 됩니다. TurboQuant는 이 "기억해 두는 컨텍스트"를 더 작게 저장합니다.
컨텍스트 길이, 배치 크기, 동시 요청 수 때문에 KV 캐시가 커질 때 TurboQuant를 사용하십시오. 메모리가 충분하거나, 기준선과 비교 중이거나, 아래 지원 구성 표에 없는 모델 계열이라면 기본 fp16 캐시를 유지하는 편이 낫습니다.
구현은 TurboQuant 논문(Zandieh et al., ICLR 2026, arXiv:2504.19874)과 독립 TurboQuant+ 프로젝트에서 검증한 PolarQuant 전용 변형을 따릅니다.
목차
KV 캐시가 중요한 이유
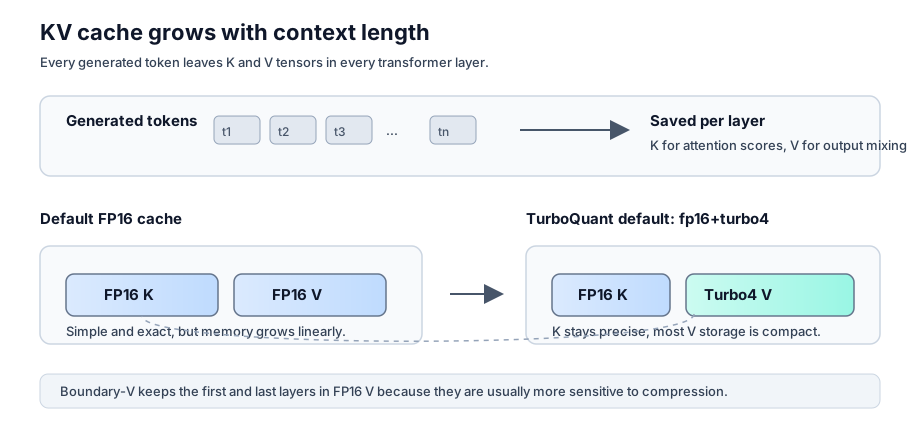
자동회귀 생성에서 모델은 매 토큰마다 이전 토큰 전체를 처음부터 다시 계산하지 않습니다. 대신 각 트랜스포머 레이어는 이미 처리한 모든 토큰에 대해 두 텐서를 저장합니다.
- K, key: 다음 토큰이 어디에 주목할지 attention score를 계산할 때 사용합니다.
- V, value: attention score에 따라 섞여 다음 hidden state를 만드는 데 사용합니다.
이 저장된 상태가 KV 캐시입니다. KV 캐시는 디코드를 실용적으로 만들지만 컨텍스트 길이, 레이어 수, KV head 수, 각 head 벡터의 크기, 활성 sequence 수에 비례해 커집니다. 여기서 활성 sequence는 동시에 디코드 중인 요청이나 배치 항목 하나를 뜻합니다. 짧은 컨텍스트에서는 모델 가중치에 비해 작을 수 있지만 긴 컨텍스트나 높은 동시성에서는 주요 메모리 비용이 됩니다.
KV 캐시는 현재 요청을 위한 모델의 작업 노트라고 생각하면 쉽습니다. 프롬프트가 길거나, 컨텍스트 윈도우가 크거나, 동시에 처리하는 사용자가 많으면 이 노트도 커집니다. TurboQuant는 이 노트를 압축해 더 긴 세션을 메모리에 유지할 수 있게 합니다.
TurboQuant가 바꾸는 것
TurboQuant는 KV 캐시의 저장 방식을 바꿉니다. 모델 가중치나 프롬프트는 그대로 두고 캐시 텐서를 저장할 때 다음 절차를 적용합니다.
- 캐시 벡터를 압축하기 쉬운 모양으로 바꿉니다.
- 각 값을 더 적은 비트로 저장합니다.
- attention 계산에서 읽어야 할 때 다시 펼칩니다.
첫 단계에는 Walsh-Hadamard transform을 사용하고 작은 저장 형식에는 PolarQuant codebook을 사용합니다. 사용자가 이 세부 요소를 직접 조정할 필요는 없습니다. 보통은 캐시 모드와 boundary 설정만 고르면 됩니다.
mlxcel의 기본 TurboQuant 권장 모드는 fp16+turbo4입니다. 이 모드는 K는 FP16으로 유지하고 V만 4비트 TurboQuant 저장 형식으로 압축합니다.
이 기본값은 의도적으로 비대칭입니다. K는 모델이 어디를 볼지 결정할 때 사용됩니다. K가 왜곡되면 모델이 잘못된 토큰을 볼 수 있습니다. V는 attention이 볼 위치를 정한 뒤 섞이는 내용에 가깝기 때문에 보통 더 안전하게 압축할 수 있습니다. 그래서 dense Q4KM 모델에서는 fp16+turbo4를 시작점으로 권장합니다.
Boundary-V 보호는 처음과 마지막 몇 개 트랜스포머 레이어의 V를 FP16으로 유지합니다. 이 레이어들은 압축에 더 민감한 경우가 많으므로, 일부 메모리 절감을 포기하고 출력 품질을 더 안정적으로 유지하는 정책입니다.
처음 선택할 모드
| 상황 | 시작 모드 |
|---|---|
| 가장 낮은 운영 위험으로 KV 메모리를 줄이고 싶을 때 | fp16+turbo4 |
| Llama, Qwen, Mistral 같은 dense Q4KM 모델을 사용할 때 | fp16+turbo4 |
| K와 V를 모두 압축해야 하고 모델 계열이 allowlist에 있을 때 | turbo4 |
| delegated hot/cold 캐시 경로를 실험할 때 | turbo4-delegated |
| V 측 압축률을 더 높이고 직접 품질을 확인할 수 있을 때 | fp16+turbo3 |
첫 배포에서는 기본 boundary 설정과 함께 fp16+turbo4를 우선 사용하십시오. 더 공격적인 모드는 실제 서비스 프롬프트 분포에서 출력 품질을 확인한 뒤 선택하는 것이 좋습니다.
캐시 모드
--kv-cache-mode 값 | K 측 | V 측 | KV 메모리 (FP16 대비) | 품질 비용 | 권장 용도 |
|---|---|---|---|---|---|
fp16 (기본) | FP16 | FP16 | 1.00배 | 없음 | 기준선 동작 |
int8 | INT8 per-token absmax | INT8 per-token absmax | 약 0.50배 | 작은 양자화 오차 | 단순 INT8 캐시 저장을 쓰는 긴 컨텍스트 |
fp16+turbo4 (별칭 turbo4-asym) | FP16 | 4비트 PolarQuant + WHT | boundary 레이어 적용 전 약 0.74배 | 지원 모델에서 낮음 | 권장 TurboQuant 기본값 |
turbo4 (별칭 turbo4-sym) | 4비트 PolarQuant + WHT | 4비트 PolarQuant + WHT | boundary 레이어 적용 전 약 0.27배 | 모델 의존 | 대칭 allowlist에 있는 모델 계열 |
fp16+turbo3 | FP16 | 3비트 PolarQuant + WHT | boundary 레이어 적용 전 약 0.72배 | Turbo4 V보다 높음 | 더 공격적인 V 측 압축 |
turbo3 | FP16 | 3비트 PolarQuant + WHT | fp16+turbo3와 같음 | fp16+turbo3와 같음 | 비대칭 Turbo3 별칭 |
turbo4-delegated | FP16 hot/cold K | FP16 hot tail + Turbo4 cold body | 긴 컨텍스트에서 약 0.74배 | fp16+turbo4와 유사 | delegated 캐시 디코드 실험 |
단순 메모리 공식은 (K_bits + V_bits) / (2 * 16)에 작은 블록별 norm sidecar 비용을 더한 값입니다. Boundary-V 보호는 일부 V 레이어를 FP16으로 유지하므로, Turbo 모드의 실제 메모리 사용량은 표의 값보다 큽니다.
표의 WHT는 Walsh-Hadamard transform을 뜻합니다. 캐시 벡터를 작은 codebook으로 저장하기 쉽게 만드는 회전 단계입니다.
CLI 플래그
mlxcel generate, mlxcel serve, mlxcel-server는 같은 TurboQuant 플래그를 공유합니다.
| 플래그 | 환경 변수 | 기본값 | 설명 |
|---|---|---|---|
--kv-cache-mode <MODE> | - | fp16 | 통합 KV 캐시 모드. 위 표의 모드 값을 받습니다. |
--cache-type-k <TYPE> | LLAMA_ARG_CACHE_TYPE_K | fp16 | K 측 llama-server 호환 split 플래그. |
--cache-type-v <TYPE> | LLAMA_ARG_CACHE_TYPE_V | fp16 | V 측 llama-server 호환 split 플래그. |
--turbo-boundary-v <COUNT> | MLXCEL_KV_BOUNDARY_V_LAYERS | 2 | Turbo 모드에서 V 캐시를 FP16으로 유지할 앞/뒤 트랜스포머 레이어 수. |
split 플래그와 --kv-cache-mode가 함께 주어지면 split 플래그가 우선하고 mlxcel은 경고를 기록합니다. split 플래그 중 하나만 주어지면 나머지 측은 fp16으로 처리됩니다.
지원되는 K/V split 조합
--cache-type-k | --cache-type-v | 실제 모드 |
|---|---|---|
fp16 | fp16 | Fp16 |
int8 | int8 | Int8 |
fp16 | turbo4 | Turbo4Asym |
fp16 | turbo4-asym | Turbo4Asym |
turbo4 | turbo4 | Turbo4 |
fp16 | turbo4-delegated | Turbo4Delegated |
fp16 | turbo3 | Turbo3Asym |
fp16 | turbo3-asym | Turbo3Asym |
다른 조합은 시작 시점에 거부되며 오류 메시지에 지원되는 쌍이 표시됩니다. 대칭 Turbo3(turbo3 / turbo3)는 노출하지 않습니다.
split 플래그는 llama.cpp에서 비양자화 FP16 저장을 가리키는 f16 표기도 fp16으로 받습니다. 그 밖의 GGML 캐시 타입(q8_0, q4_0, q4_1, iq4_nl, q5_0, q5_1, f32, bf16)은 mlxcel 모드와 수치적으로 같지 않으므로 이유를 설명하는 오류와 함께 거부됩니다. 여기서 int8은 토큰별 absmax 방식이고 Turbo 모드는 Walsh-Hadamard 회전을 쓰는 PolarQuant입니다. fp16+turbo4-delegated는 turbo4-delegated의 별칭으로 받습니다.
예시
오프라인 생성
# 권장 TurboQuant 기본값: FP16 K, Turbo4 V.
mlxcel generate -m models/<model> --kv-cache-mode fp16+turbo4 -p "Hello" -n 200

# 대칭 Turbo4. allowlist에 있는 모델 계열에만 사용하십시오.
mlxcel generate -m models/<model> --kv-cache-mode turbo4 -p "Hello" -n 200

# delegated 캐시 경로.
mlxcel generate -m models/<model> --kv-cache-mode turbo4-delegated -p "Hello" -n 200
서버
# 통합 모드 플래그.
mlxcel-server -m models/<model> --kv-cache-mode fp16+turbo4

# llama-server 호환 split 플래그.
mlxcel-server -m models/<model> --cache-type-k fp16 --cache-type-v turbo4

# 같은 설정을 환경 변수로 지정.
LLAMA_ARG_CACHE_TYPE_K=fp16 LLAMA_ARG_CACHE_TYPE_V=turbo4 mlxcel-server -m models/<model>
튜닝
Boundary-V 레이어 보호
Turbo 모드가 활성화되면 앞/뒤 --turbo-boundary-v개의 트랜스포머 레이어는 FP16 V 캐시를 유지합니다. 기본값은 2이며 TurboQuant+ 검증 작업에서 사용한 LA-V7 정책과 같은 방향입니다.
mlxcel generate --kv-cache-mode fp16+turbo4 --turbo-boundary-v 2 \
    -m models/<model> -p "Hello" -n 50

# 같은 설정을 환경 변수로 지정.
MLXCEL_KV_BOUNDARY_V_LAYERS=4 mlxcel generate --kv-cache-mode fp16+turbo4 ...
특수 값:
0: boundary 보호를 비활성화합니다.2: 기본값이며 일반적인 28~64 레이어 모델에 적합합니다.n_layers / 2보다 큰 값은 잘립니다. 예를 들어 4레이어 모델에--turbo-boundary-v 8을 지정하면 4개 레이어 모두 FP16으로 유지되고 오류는 발생하지 않습니다.
Sparse-V dequant 임계값
attention 가중치가 임계값보다 낮은 위치에서는 출력 기여가 작기 때문에 V dequantization을 건너뛸 수 있습니다.
기본 임계값은 1e-6입니다. macOS에서는 임계값이 0이 아닐 때 fused Metal 커널이 사용됩니다. graph reference 경로와 비교하려면 MLXCEL_SPARSE_V_KERNEL=0을 설정하십시오.
Delegated 캐시 변형
delegated 캐시는 최근 토큰을 FP16으로 유지하고 오래된 V 토큰은 Turbo4 형태로 저장합니다. 즉, 최근 부분은 읽기 쉬운 형태로 두고 오래된 부분은 작게 저장하는 구조입니다. 아래 변수들은 실험과 성능 비교를 위한 고급 설정입니다.
| 환경 변수 | 효과 |
|---|---|
MLXCEL_TURBO4_DELEGATED_DEQUANT_SDPA=0 | 기본 dequant-first SDPA 경로 대신 구형 커스텀 packed-V Metal 경로를 사용합니다. |
MLXCEL_TURBO4_DELEGATED_FUSED=1 | dequant-first SDPA가 꺼진 상태에서 cold-only fused composition 커널을 사용합니다. |
MLXCEL_TURBO4_DELEGATED_FP16_FAST_PATH=1 | packed sidecar와 별도로 FP16 V working set을 유지합니다. 속도 비교에는 유용하지만 압축 메모리 목표는 충족하지 않습니다. |
MLXCEL_TURBO4_DELEGATED_FP16_SIDECARS=lazy | FP16 fast path가 활성화된 상태에서 sidecar fold를 캐시 보존 시점까지 늦춥니다. |
지원 구성
| 모델 계열 | 권장 모드 | 대칭 turbo4 |
|---|---|---|
| Llama 3.x, Qwen 2.5, Qwen 3, Mistral dense Q4KM 모델 | fp16+turbo4 | 기본 allowlist에는 없음 |
| Qwen3.5 및 Qwen3-Next 계열 | fp16+turbo4, 대칭 모드가 필요하면 turbo4 | allowlist에 있음 |
| Qwen 2-VL, Qwen 2.5-VL, Aya-Vision VLM | 지원되는 text/VLM 사례에서는 fp16+turbo4 | 대칭 turbo4 미검증 |
| Gemma 3 및 Gemma 4 | 로컬에서 직접 테스트하지 않았다면 fp16 사용 | 미검증 |
현재 대칭 turbo4 allowlist 항목은 qwen3_5, qwen3_5_moe, qwen3_next입니다. Q8 모델과 70B 이상 Q4KM 모델은 향후 allowlist 후보가 될 수 있지만 런타임이 가중치 등급을 식별하고 해당 계열이 별도 테스트를 통과하기 전에는 일반적으로 활성화된 것으로 문서화하지 않습니다.
allowlist 밖의 dense Q4KM 모델에서 대칭 turbo4를 사용하면 K 측 양자화가 attention score에 영향을 주어 PPL이 크게 악화될 수 있습니다. 이런 모델에는 fp16+turbo4를 사용하십시오.
알려진 제한 사항
헤드 차원 제약
TurboQuant는 64, 128, 256 같은 2의 거듭제곱 헤드 차원이 필요합니다. 80, 96, 192 같은 헤드 차원은 패딩 없이 TurboQuant를 사용할 수 없으며 캐시 초기화 시점에 거부됩니다.
대칭 Turbo3
대칭 turbo3는 노출하지 않습니다. --kv-cache-mode turbo3와 --cache-type-v turbo3는 비대칭 fp16+turbo3 모드로 해석됩니다.
Paged KV 스케줄러
--kv-cache-mode <turbo4-variant> --decode-storage-backend paged는 서버 디스패치 경로에 연결되어 있습니다. Apple Silicon에서 디코드 처리량과 동시 prefix 일관성에 대한 종단 간 검증은 아직 진행 중입니다.
M5 Max delegated 디코드 속도
M5 Max에서 기본 압축 turbo4-delegated 경로는 0.97배 FP16 디코드 속도 목표를 항상 만족하지는 않습니다. MLXCEL_TURBO4_DELEGATED_FP16_FAST_PATH=1 변형은 속도 실험에 사용할 수 있지만 FP16 V working set 전체를 유지하므로 메모리 특성이 달라집니다.
M3 이전 하드웨어
turbo3는 M1/M2 GPU 마이크로아키텍처에서 대역폭 병목을 만들 수 있습니다. M1/M2의 디코드 중심 작업에서는 fp16+turbo4를 우선 사용하십시오.
VLM 커버리지
현재 측정은 Qwen 2.5-VL 3B 대리 모델로 Qwen2-VL 2B를 사용하고 Aya-Vision 8B를 4K 이하 컨텍스트에서 검증합니다. 다른 VLM 계열과 8K 초과 멀티 이미지 프롬프트는 별도 검증이 필요합니다.