네이티브 로컬 AI 추론,설치는 간단하게
LLM, 비전-언어 모델, 임베딩, 재순위화 모델을 Hugging Face SafeTensors 체크포인트 그대로 실행합니다. 아카이브 하나 또는 Homebrew 명령 한 줄로 설치해 바로 서빙할 수 있습니다.
- macOS · Apple Silicon
- Linux · NVIDIA CUDA
- Linux · AMD ROCm
- Windows · CUDA, ROCm
curl -fsSL https://mlxcel.ai/install.sh | sh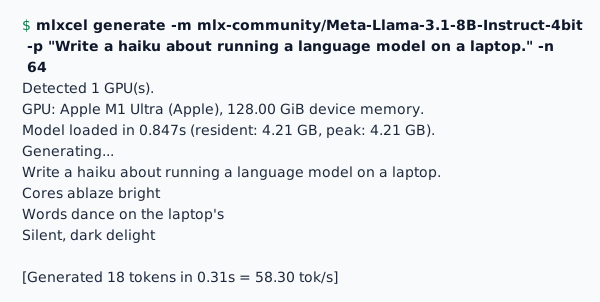
터미널에서 바로 텍스트 생성. 지원하는 모델을 명령 하나로 실행하고 샘플링, 반복 페널티, 출력 형식을 옵션으로 지정합니다.
첫 모델 실행하기
mlxcel을 설치하고 Qwen3-4B 예제를 실행한 뒤 첫 요청을 보내세요.
curl -fsSL https://mlxcel.ai/install.sh | sh \ && export PATH="$HOME/.local/bin:$PATH"예제 모델 시작
같은 터미널에서 실행하세요. 캐시에 없는 Qwen3-4B 체크포인트는 첫 실행 시 다운로드하므로 인터넷 연결과 디스크 공간이 필요합니다. 서버를 실행한 상태로 두세요.
다른 모델 선택mlxcel serve -m mlx-community/Qwen3-4B-4bit --alias qwen3-4b \ --ctx-size 8192 --n-parallel 4curl http://127.0.0.1:8080/v1/chat/completions \ -H "Content-Type: application/json" \ -d '{"model":"qwen3-4b","messages":[{"role":"user","content":"Hello"}]}'
기능
- 아키텍처
- 모델 로더, 스케줄러, 추론 루프가 하나의 네이티브 Rust 프로세스에서 실행되며 Python 환경이나 컨테이너가 필요하지 않습니다. Apple Silicon(M1~M5)의 Metal, NVIDIA의 CUDA, AMD의 ROCm이 같은 MLX 기반 엔진을 실행합니다.
- 지원 모델 범위
- Llama, Qwen, Gemma, DeepSeek, Nemotron-H 등 밀집 트랜스포머, MoE, SSM, 하이브리드 모델과 비전-언어, 임베딩, 재순위화, 음성, 객체 탐지 런타임을 지원합니다. 4비트·8비트·1비트 및 MXFP4·MXFP8·NVFP4 체크포인트를 변환 없이 불러옵니다.
- 지원 API
- mlxcel-server는 OpenAI chat/completions와 Responses, Anthropic Messages, 오디오, 실시간 음성, 임베딩, 재순위화, 내장 WebUI를 프로세스 하나에서 제공하며 SSE 스트리밍과 도구 호출을 지원합니다. 지원 목록에 있는 llama-server 플래그와 LLAMA_ARG_* 환경 변수도 받습니다.
- 메모리와 캐시
- 페이지드 KV 캐시로 요청별 메모리를 관리하고 프롬프트 프리픽스 캐시로 이전 연산을 재사용합니다. 메모리가 부족하면 INT8과 TurboQuant 모드로 KV 캐시를 줄일 수 있고, 메모리 추정으로 모델과 컨텍스트가 장비에 맞는지 불러오기 전에 확인합니다.
- 스케줄링과 디코딩
- 지원 모델에서 연속 배칭, MTP·DFlash 및 초안 모델 없는 프롬프트 룩업 추측 디코딩, 블록 디퓨전을 제공합니다. 런타임 모델 변환과 언어 바이어스 정책으로 재학습 없이 동작을 조정합니다.
- 확장
- 텐서 병렬화는 모델을 여러 GPU에 나누고 파이프라인 병렬화는 레이어를 여러 머신에 배정하며, mDNS 노드 탐색과 프리필·디코드 분리 실행을 지원합니다. Backend.AI GO와 Backend.AI 클러스터의 추론 엔진이므로 같은 모델을 공유 GPU 인프라로 옮길 수 있습니다.
성능
| 모델 | 분류 | 프리필tok/s | 디코드tok/s |
|---|---|---|---|
| smollm-135m-4bit소형 밀집 | 53,385.5 | 475.0 | |
| qwen3-4b-4bit밀집 | 7,111.4 | 85.2 | |
| llama-3.1-8b-4bit밀집 | 4,207.6 | 49.8 | |
| gpt-oss-20b-mxfp4MoE | 736.2 | 89.4 | |
| mixtral-8x7b-4bitMoE | 352.3 | 28.3 | |
| qwen3.5-35b-a3b-4bit하이브리드 MoE | 464.0 | 73.1 | |
| nemotron-h-30b-4bit하이브리드 SSM/MoE | 206.9 | 93.9 |
다운로드
macOS(Apple Silicon)와 Linux(CUDA)용 최신 릴리스입니다. v0.8.1
| 파일 | 플랫폼 | 구성 | 크기 | 형식 |
|---|---|---|---|---|
macOS · Apple Silicon · Metal · CLI와 서버 · ZIP | 86.5 MB | ZIP | ||
Linux · x64 · CUDA 13 · CLI와 서버 · ZIP | 171.4 MB | ZIP | ||
Linux · ARM64 · CUDA 13 · CLI와 서버 · ZIP | 102.3 MB | ZIP |
Homebrew
Homebrew로 macOS 릴리스를 설치합니다.
나중에 새 릴리스로 올릴 때:
Apple Silicon Mac의 Homebrew가 필요합니다. 안정 버전이 나올 때마다 formula도 함께 갱신됩니다.
소스에서 빌드
CUDA·ROCm 툴체인이나 빌드 기능을 직접 설정하거나 설치 파일이 없는 머신에서 사용하세요.
$ git clone https://github.com/lablup/mlxcel.git$ && cd mlxcel$ && cargo build --release --features metal,accelerateXcode의 Metal Toolchain이 필요합니다.
모든 빌드에는 rust-toolchain.toml에 고정된 Rust 1.97이 필요하며 첫 빌드 때 rustup이 자동으로 설치합니다. 전체 사전 요구 사항은 매뉴얼에 있습니다.